第 3 章 eBPF 程序剖析
在前一章中,您已经看到了一个使用 BCC 框架编写的简单的 eBPF“Hello World”程序。在本章中,有一个完全用 C 语言编写的“Hello World”程序示例,以便您能够看到 BCC 在幕后处理的一些细节。
本章还展示了 eBPF 程序从源代码到执行过程中所经历的各个阶段,如图 3-1 所示。
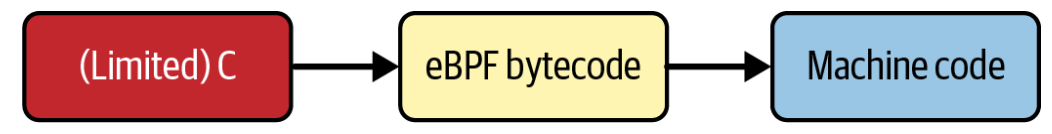
图 3-1. C(或 Rust)源代码被编译为 eBPF 字节码,该字节码要么可以被即时编译(JIT-compiled),要么被解释成本地机器代码指令
eBPF 程序是一组 eBPF 字节码指令。可以直接用编写 eBPF 字节码的方式编写 eBPF 代码,就像可以用汇编语言编程一样。通常,人们更容易处理高级编程语言。至少在撰写本文时,我可以说绝大多数 eBPF 代码是用 C 语言1编写的,然后编译成 eBPF 字节码。
从概念上讲,这些字节码在内核中的 eBPF 虚拟机中运行。
eBPF 虚拟机
eBPF 虚拟机,和其他虚拟机一样,是计算机软件实现的。它接收以 eBPF 字节码指令形式表示的程序,并将这些指令转换为在 CPU 上运行的本地机器指令。
在早期的 eBPF 实现中,字节码指令是在内核中解释执行的——也就是说,每次运行 eBPF 程序时,内核都会检查指令并将其转换为机器码,然后执行它们。出于性能原因以及为了避免 eBPF 解释器中出现一些 Spectre 相关的漏洞,解释执行已在很大程度上被即时(just-in-time,JIT)编译替代。编译意味着当程序加载到内核时,从字节码到本机机器指令的转换只发生一次。
eBPF 字节码由一组指令组成,这些指令作用于(虚拟的)eBPF 寄存器。eBPF 指令集和寄存器模型的设计旨在与常见的 CPU 架构相匹配,以便将字节码编译或解释为机器码的步骤相对简单。
eBPF 寄存器
eBPF 虚拟机使用 10 个通用寄存器,编号从 0 到 9。此外,寄存器 10 被用作栈帧指针(只能读取,不能写入)。在执行 BPF 程序时,这些寄存器中存储的值用于跟踪状态。
需要理解的是,eBPF 虚拟机中的这些寄存器是通过软件实现的。您可以在 Linux 内核源代码的 include/uapi/linux/bpf.h 头文件中看到它们,从 BPF_REG_0 到 BPF_REG_10。
在 eBPF 程序开始执行之前,上下文参数被加载到寄存器 1 中。函数的返回值存储在寄存器 0 中。
eBPF 代码在调用函数之前,该函数的参数被放置在寄存器 1 到寄存器 5 中(如果参数少于五个,则不会使用所有寄存器)。
eBPF 指令
同样的 linux/bpf.h 头文件定义了一个名为 bpf_insn 的结构体,该结构体代表一条 BPF 指令:
struct bpf_insn {
	__u8	code;		/* opcode */  // 1
	__u8	dst_reg:4;	/* dest register */  // 2
	__u8	src_reg:4;	/* source register */
	__s16	off;		/* signed offset */  // 3
	__s32	imm;		/* signed immediate constant */
};
- 每条指令都有一个操作码,用于定义该指令要执行的操作:例如,将一个值加到寄存器(所存储的值)中,或跳转到程序中的另一条指令2。Iovisor 项目的“非官方 eBPF 规范(Unofficial eBPF spec)”中列出了有效指令的列表。
- 不同的操作可能涉及最多两个寄存器。
- 根据操作的不同,可能还会有一个偏移值和/或一个“立即”整数值。
bpf_insn 结构体的长度为 64 位(或 8 字节)。然而,有时一条指令可能需要多于 8 字节的空间。如果要将寄存器设置为 64 位值,则无法将该值的所有 64 位与操作码和寄存器信息一起挤进一个结构体中。在这些情况下,指令使用总长度为 16 字节的宽指令编码。您将在本章中看到这方面的示例。
当加载到内核中时,eBPF 程序的字节码由一系列 bpf_insn 结构体表示。验证器对这些信息进行多项检查,以确保代码的运行安全。您将在第 6 章中了解更多关于验证过程的内容。
大多数不同的操作码可以分为以下几类:
- 将一个值加载到寄存器中(可以是立即数、从内存或其他寄存器读取的值)
- 将一个寄存器中的值存储到内存中
- 执行算术操作,例如,将一个值加到寄存器中
- 如果满足特定条件,则跳转到另一条指令
note
关于 eBPF 架构的概述,我推荐 Cilium 项目文档中的 BPF 和 XDP 参考指南。如果您需要更多详细信息,内核文档清晰的描述了 eBPF 指令和编码。
让我们使用另一个简单的 eBPF 程序示例,并跟踪它从 C 源代码,到 eBPF 字节码,再到机器码指令的过程。
note
如果您想自己构建并运行此代码,可以在 github.com/lizrice/learning-ebpf 上找到代码及设置环境的说明。本章的代码在 chapter3 目录中。
本章中的示例是使用名为 libbpf 的库,用 C 语言编写的。您将在第 5 章中了解有关该库的更多信息。
用于网络接口的 eBPF “Hello World”
上一章中的示例通过系统调用的 kprobe 触发了“Hello World”的跟踪输出;这次我要展示一个 eBPF 程序,当网络数据包到达时触发,输出一行跟踪信息。
数据包处理是 eBPF 的一个非常常见的应用。在第 8 章中,我将详细介绍这个内容。但现在,了解每次数据包到达网络接口时,会触发 eBPF 程序的基本概念可能会有所帮助。该程序可以检查甚至修改数据包的内容,并对内核如何处理该数据包做出决定(或判决(verdict))。判决可以指示内核按常规处理它、丢弃它或将其重定向到其他地方。
在这里展示的简单示例中,程序不会对网络数据包做任何处理;它只是在每次接收到网络数据包时,将 Hello World 和一个计数器写入跟踪管道。
示例程序位于 chapter3/hello.bpf.c 中。为了将 eBPF 程序与可能存在于相同源代码目录中的用户空间 C 代码区分开来,将 eBPF 程序放在以 bpf.c 结尾的文件名中是一种相当常见的约定。以下是整个程序:
#include <linux/bpf.h>  // 1
#include <bpf/bpf_helpers.h>

int counter = 0;  // 2

SEC("xdp")  // 3
int hello(struct xdp_md *ctx) {  // 4
    bpf_printk("Hello World %d", counter);
    counter++;
    return XDP_PASS;
}

char LICENSE[] SEC("license") = "Dual BSD/GPL";  // 5
- 此示例首先包含了一些头文件。假设您不熟悉 C 编程,每个程序都必须包含定义程序将要使用的任何结构体或函数的头文件。从这些头文件的名称可以看出,它们与 BPF 有关。
- 该示例展示了 eBPF 程序如何使用全局变量。每次程序运行时,这个计数器都会递增。
- 宏
SEC()定义了一个名为xdp的段(section),您将在编译后的目标文件中看到它。稍后在第 5 章中,我会详细解释段名称的用法,但现在您可以简单地将其视为定义一个 eXpress Data Path(XDP)类型的 eBPF 程序。 - 这里可以看到实际的 eBPF 程序。在 eBPF 中,程序名称就是函数名称,所以这个程序名为
hello。它使用一个辅助函数bpf_printk来输出一串文本,递增全局变量counter,然后返回值XDP_PASS。这是指示内核正常处理此网络包的判决。 - 最后,还有另一个定义许可证字符串的
SEC()宏,这是 eBPF 程序的关键要求。内核中的一些 BPF 辅助函数被定义为“仅限 GPL(GPL only)”。如果您想使用这些函数,您的 BPF 代码必须声明为具有 GPL 兼容的许可证。如果声明的许可证与程序使用的函数不兼容,验证器(我们将在第 6 章中讨论)会拒绝加载。某些类型的 eBPF 程序,包括使用 BPF LSM 的程序(将在第 9 章介绍),也必须符合 GPL 兼容性要求。
note
您可能想知道为什么前一章使用 bpf_trace_printk() ,而这个版本使用 bpf_printk()。简而言之,BCC 的版本叫做 bpf_trace_printk(),而 libbpf 的版本叫做 bpf_printk(),但这两个都是对内核函数 bpf_trace_printk() 的封装。Andrii Nakryiko 在他的博客上写了一篇很好的贴子。
这是一个附加到网络接口上的 XDP 钩子点的 eBPF 程序示例。您可以将 XDP 事件视为在网络数据包到达(物理或虚拟)网络接口时立即触发。
note
一些网卡支持将 XDP 程序卸载(offload)到网卡本身执行。这意味着每个到达的网络数据包都可以在网卡上处理,而不会接触到机器的 CPU。XDP 程序可以检查甚至修改每个网络数据包,因此这对于进行 DDoS 防护、防火墙或负载均衡等高性能操作非常有用。您将在第 8 章中进一步了解此功能。
您已经看到了 C 源代码,下一步是将其编译成内核可以理解的目标文件。
编译 eBPF 目标文件
我们的 eBPF 源代码需要编译成 eBPF 虚拟机能理解的机器指令:eBPF 字节码。LLVM 项目中的 Clang 编译器可以通过指定 -target bpf 来完成这项任务。以下是一个 Makefile 的摘录,用于进行编译:
hello.bpf.o: %.o: %.c
	clang \
	    -target bpf \
		-I/usr/include/$(shell uname -m)-linux-gnu \
		-g \
	    -O2 -c $< -o $@
这将从 hello.bpf.c 源代码生成一个名为 hello.bpf.o 的目标文件。这里的 -g 标志是可选的3,它可以生成调试信息,这样您在检查目标文件时可以同时看到源代码和字节码。让我们检查一下这个目标文件,以便更好地理解它包含的 eBPF 代码。
检查 eBPF 目标文件
通常使用 file 工具来确定文件的内容:
$ file hello.bpf.o
hello.bpf.o: ELF 64-bit LSB relocatable, eBPF, version 1 (SYSV), with debug_info, not stripped
这表明它是一个 ELF(Executable and Linkable Format,可执行和可链接格式)文件,包含 eBPF 代码,适用于具有 LSB(最低有效位)架构的 64 位平台。如果在编译步骤中使用了-g标志,它将包含调试信息。
您可以使用 llvm-objdump 进一步检查此目标文件,以查看其中的 eBPF 指令:
$ llvm-objdump -S hello.bpf.o
即使您不熟悉反汇编,此命令的输出也不难理解:
hello.bpf.o:    file format elf64-bpf  # 1

Disassembly of section xdp:  # 2

0000000000000000 <hello>:  # 3
;     bpf_printk("Hello World %d", counter);  # 4
       0:       18 06 00 00 00 00 00 00 00 00 00 00 00 00 00 00 r6 = 0 ll
       2:       61 63 00 00 00 00 00 00 r3 = *(u32 *)(r6 + 0)
       3:       18 01 00 00 00 00 00 00 00 00 00 00 00 00 00 00 r1 = 0 ll
       5:       b7 02 00 00 0f 00 00 00 r2 = 15
       6:       85 00 00 00 06 00 00 00 call 6
;     counter++;  # 5
       7:       61 61 00 00 00 00 00 00 r1 = *(u32 *)(r6 + 0)
       8:       07 01 00 00 01 00 00 00 r1 += 1
       9:       63 16 00 00 00 00 00 00 *(u32 *)(r6 + 0) = r1
;     return XDP_PASS;  # 6
      10:       b7 00 00 00 02 00 00 00 r0 = 2
      11:       95 00 00 00 00 00 00 00 exit
- 第一行进一步确认了 hello.bpf.o 是一个 64 位 ELF 文件,包含 eBPF 代码(有些工具使用 BPF 术语,有些使用 eBPF 术语,没有特别的原因;正如之前所说,这些术语现在几乎是可以互换使用)。
- 接下来是
xdp段的反汇编,与 C 源代码中的SEC()定义相匹配。 - 该段是一个名为
hello的函数。 - 源代码中的
bpf_printk("Hello World %d", counter");行对应的五行 eBPF 字节码指令。 - 三行 eBPF 字节码指令用于增加变量
counter。 - 另外两行字节码由源代码
return XDP_PASS;生成。
除非您特别有兴趣,否则没有必要准确理解每行字节码如何与源代码相关联。编译器会生成字节码,使您不必去考虑这些细节!但让我们稍微详细地查看输出,以便您能够了解这些输出与您本章早些时候学习的 eBPF 指令和寄存器之间的关系。
在每行字节码的左侧,您可以看到该指令在内存中相对于 hello 所在位置的偏移量。正如本章前面所述,eBPF 指令长度通常是 8 字节,而在 64 位平台上,每个内存位置可以容纳 8 字节,因此偏移量通常会每条指令递增 1。然而,该程序中的第一条指令恰好需要 16 字节的宽指令编码,以便将寄存器 6 设置为 64 位值 0。因此,输出的第二行指令的偏移量为 2。之后还有一个 16 字节的指令,将寄存器 1 设置为 64 位值 0。再往后,剩下的指令每条占用 8 字节,因此每行的偏移量递增一。
每行的第一个字节是操作码,指示内核执行的操作,指令行的右侧是人类可读的指令解释。撰写本文时,Iovisor 项目有最完整的 eBPF 操作码文档,但官方的 Linux 内核文档正在逐步完善,eBPF 基金会正在制定不依赖于特定操作系统的标准文档。
例如,我们来看一下偏移量为 5 的指令,如下所示:
5: b7 02 00 00 0f 00 00 00 r2 = 15
这条指令的操作码是0xb7,根据文档的说明,其对应的伪代码是 dst = imm,可以理解为“将目标寄存器设置为立即数”。目标由第二个字节 0x02 定义,表示“寄存器 2”。这里的“立即”(或字面)数是 0x0f,即十进制的 15。因此,我们可以理解这条指令是告诉内核“将寄存器 2 设置为值 15”。这与指令右侧看到的输出相对应:r2 = 15。
偏移量为 10 的指令类似:
10: b7 00 00 00 02 00 00 00 r0 = 2
这行指令同样使用操作码 0xb7,这次是将寄存器 0 的值设置为 2。当一个 eBPF 程序运行结束时,寄存器 0 存放返回值,而 XDP_PASS 的值是 2。这与源代码中的逻辑一致,即始终返回 XDP_PASS。
您现在知道了 hello.bpf.o 包含一个以字节码形式存在的 eBPF 程序。下一步是将其加载到内核中。
将程序加载到内核中
在这个示例中,我们将使用一个名为 bpftool 的工具。您也可以通过编程的方式加载程序,稍后在书中您将看到相关示例。
note
某些 Linux 发行版提供了包含 bpftool 的软件包,或者您可以从源代码编译。您可以在 Quentin Monnet 的博客上找到有关安装或构建此工具的更多详细信息,也可以在 Cilium 网站上找到更多文档和用法。
下面是使用 bpftool 将程序加载到内核的示例。请注意,您可能需要以 root 身份(或使用 sudo)获得 bpftool 所需的 BPF 权限。
$ bpftool prog load hello.bpf.o /sys/fs/bpf/hello
这将从我们编译的目标文件中加载 eBPF 程序,并将其“固定”到位置 /sys/fs/bpf/hello4。对于该命令,没有输出响应表明成功,您也可以使用 ls 确认程序是否已就位:
$ ls /sys/fs/bpf
hello
eBPF 程序已成功加载。让我们使用 bpftool 工具了解有关该程序及其在内核中的状态的更多信息。
检查已加载的程序
bpftool 工具可以列出加载到内核中的所有程序。如果您自己尝试,可能会在输出中看到几个预先存在的 eBPF 程序,但为了清楚起见,我只展示与我们的“Hello World”示例相关的行:
$ bpftool prog list
...
540: xdp name hello tag d35b94b4c0c10efb gpl
    loaded_at 2022-08-02T17:39:47+0000 uid 0
    xlated 96B jited 148B memlock 4096B map_ids 165,166
    btf_id 254
程序已被分配 ID 540。此标识是为每个加载的程序分配的编号。知道 ID 后,您可以使用 bpftool 显示有关此程序的更多信息。这次,我们以美化的 JSON 格式输出,以便字段名称和值可见:
$ bpftool prog show id 540 --pretty
{
    "id": 540,
    "type": "xdp",
    "name": "hello",
    "tag": "d35b94b4c0c10efb",
    "gpl_compatible": true,
    "loaded_at": 1659461987,
    "uid": 0,
    "bytes_xlated": 96,
    "jited": true,
    "bytes_jited": 148,
    "bytes_memlock": 4096,
    "map_ids": [165,166
    ],
    "btf_id": 254
}
根据字段名称,很多内容都很容易理解:
- 程序的 ID 是 540。
type字段告诉我们这个程序可以使用 XDP 事件附加到网络接口。其他类型的 BPF 程序可以附加到不同类型的事件上,我们将在第七章中详细讨论这一点。- 程序名称为
hello,这是源代码中的函数名称。 tag是该程序的另一个标识符,我稍后会详细描述。- 该程序采用 GPL 兼容许可证。
- 有一个时间戳显示程序的加载时间。
- 用户 ID 0(即 root)加载了该程序。
- 此程序中有 96 字节的翻译后的 eBPF 字节码,我会在稍后向您展示。
- 该程序已经过 JIT 编译,编译产生了 148 字节的机器码,我也会在稍后介绍。
bytes_memlock字段告诉我们,此程序保留了 4,096 字节的内存,这些内存不会被分页。- 该程序引用了 ID 为 165 和 166 的 BPF 映射。由于在源代码中没有明显的映射引用,这可能会让人感到意外。您将在本章稍后看到如何使用映射语义来处理 eBPF 程序中的全局数据。
- 您将在第 5 章学习有关 BTF 的内容,现在只需要知道
btf_id表示该程序有一个 BTF 信息块。只有在使用-g标志进行编译时,才会将此信息包含在目标文件中。
BPF 程序标签(tag)
标签(tag)是所有程序指令的 SHA(Secure Hashing Algorithm,安全哈希算法)散列值,可以用作程序的另一个标识符。每次加载或卸载程序时,ID 可能会变化,但标签将保持不变。bpftool 工具接受通过 ID、名称、标签或固定路径来引用 BPF 程序,因此在此示例中,以下所有命令将给出相同的输出:
bpftool prog show id 540bpftool prog show name hellobpftool prog show tag d35b94b4c0c10efbbpftool prog show pinned /sys/fs/bpf/hello
您可以拥有多个同名的程序,甚至是具有相同标签的多个程序实例,但 ID 和固定路径始终是唯一的。
翻译后的字节码
bytes_xlated 字段告诉我们有多少字节的“翻译后”eBPF 代码。这是 eBPF 字节码在通过验证器之后(并可能被内核修改,原因我将在本书后面讨论)得到的结果。
让我们使用 bpftool 来显示我们“Hello World”代码的翻译版本:
$ bpftool prog dump xlated name hello
int hello(struct xdp_md * ctx):
; bpf_printk("Hello World %d", counter);
    0: (18) r6 = map[id:165][0]+0
    2: (61) r3 = *(u32 *)(r6 +0)
    3: (18) r1 = map[id:166][0]+0
    5: (b7) r2 = 15
    6: (85) call bpf_trace_printk#-78032
; counter++;
    7: (61) r1 = *(u32 *)(r6 +0)
    8: (07) r1 += 1
    9: (63) *(u32 *)(r6 +0) = r1
; return XDP_PASS;
    10: (b7) r0 = 2
    11: (95) exit
这与您之前从 llvm-objdump 输出中看到的反汇编代码非常相似。偏移地址相同,指令也相似——例如,我们可以看到偏移量为 5 的指令是 r2=15。
JIT 编译的机器代码
翻译后的字节码虽然很低级,但还不是机器代码。eBPF 使用 JIT 编译器将 eBPF 字节码转换为在目标 CPU 上本地运行的机器代码。bytes_jited 字段显示,经此转换之后,程序长度为 108 字节。
note
为了获得更高的性能,eBPF 程序通常会进行 JIT 编译。另一种选择是在运行时解释 eBPF 字节码。eBPF 指令集和寄存器的设计与本机机器指令相当接近,使得解释直接且相对快速,但编译后的程序会更快,现在大多数架构都支持 JIT5。
bpftool 工具可以生成这个 JIT 代码的汇编语言转储。即便您对汇编语言不熟悉,这看起来完全不可理解也无需担心!我之所以将其包括在内,是为了展示 eBPF 代码从源代码到可执行机器指令所经历的所有转换过程。以下是命令及其输出:
$ bpftool prog dump jited name hello
int hello(struct xdp_md * ctx):
bpf_prog_d35b94b4c0c10efb_hello:
; bpf_printk("Hello World %d", counter);
    0: hint #34
    4: stp x29, x30, [sp, #-16]!
    8: mov x29, sp
    c: stp x19, x20, [sp, #-16]!
    10: stp x21, x22, [sp, #-16]!
    14: stp x25, x26, [sp, #-16]!
    18: mov x25, sp
    1c: mov x26, #0
    20: hint #36
    24: sub sp, sp, #0
    28: mov x19, #-140733193388033
    2c: movk x19, #2190, lsl #16
    30: movk x19, #49152
    34: mov x10, #0
    38: ldr w2, [x19, x10]
    3c: mov x0, #-205419695833089
    40: movk x0, #709, lsl #16
    44: movk x0, #5904
    48: mov x1, #15
    4c: mov x10, #-6992
    50: movk x10, #29844, lsl #16
    54: movk x10, #56832, lsl #32
    58: blr x10
    5c: add x7, x0, #0
; counter++;
    60: mov x10, #0
    64: ldr w0, [x19, x10]
    68: add x0, x0, #1
    6c: mov x10, #0
    70: str w0, [x19, x10]
; return XDP_PASS;
    74: mov x7, #2
    78: mov sp, sp
    7c: ldp x25, x26, [sp], #16
    80: ldp x21, x22, [sp], #16
    84: ldp x19, x20, [sp], #16
    88: ldp x29, x30, [sp], #16
    8c: add x0, x7, #0
    90: ret
note
某些打包的 bpftool 发行版尚不支持转储 JIT 输出。如果出现这种情况,您将看到“Error: No libbfd support.”。您可以按照 https://github.com/libbpf/bpftool 上的说明自行构建 bpftool。
您已经看到,“Hello World”程序已加载到内核中,但此时它尚未与事件关联,因此没有任何东西会触发它运行。它需要附加到一个事件上。
附加到事件
程序类型必须与其附加的事件类型匹配;您将在第 7 章中了解更多相关信息。本示例是一个 XDP 程序,您可以使用 bpftool 将示例 eBPF 程序附加到网络接口上的 XDP 事件,如下所示:
$ bpftool net attach xdp id 540 dev eth0
note
在撰写本文时,bpftool 工具还不支持附加所有程序类型,但最近已扩展以自动附加 k(ret)probes、u(ret)probes 和 tracepoints。
这里,我使用了程序的 ID 540,但您也可以使用名称(前提是它是唯一的)或标签来标识要附加的程序。在此示例中,我已将程序附加到网络接口 eth0。
您可以使用 bpftool 查看所有网络附加的 eBPF 程序:
$ bpftool net list
xdp:
eth0(2) driver id 540

tc:

flow_dissector:
ID 为 540 的程序已附加到 eth0 接口上的 XDP 事件。此输出还提供了一些有关网络协议栈中可以附加 eBPF 程序的其他潜在事件的线索:tc 和 flow_dissector。更多内容请参阅第 7 章。
您还可以使用 ip link 检查网络接口,输出如下所示(为清晰起见,已删除了一些细节):
1: lo: <LOOPBACK,UP,LOWER_UP> mtu 65536 qdisc noqueue state UNKNOWN mode DEFAULT
group default qlen 1000
    ...
2: eth0: <BROADCAST,MULTICAST,UP,LOWER_UP> mtu 1500 xdp qdisc fq_codel state UP
mode DEFAULT group default qlen 1000
    ...
    prog/xdp id 540 tag 9d0e949f89f1a82c jited
    ...
在此示例中,有两个接口:用于将流量发送到本机进程的回环接口 lo,以及将本机连接到外界的 eth0 接口。此输出还显示 eth0 有一个 JIT 编译的 eBPF 程序,其 ID 为 540,标签为 9d0e949f89f1a82c,附加到其 XDP 钩子上。
note
您也可以使用 ip link 将 XDP 程序附加到网络接口或将其从接口分离。我已将其作为本章结尾的练习,并在第 7 章中提供了更多示例。
此时,每当接收到网络数据包时,eBPF 程序 hello 会产生跟踪输出。您可以通过运行 cat /sys/kernel/debug/tracing/trace_pipe 来检查。这应该会显示大量类似如下的输出:
<idle>-0    [003] d.s.. 655370.944105: bpf_trace_printk: Hello World 4531
<idle>-0    [003] d.s.. 655370.944587: bpf_trace_printk: Hello World 4532
<idle>-0    [003] d.s.. 655370.944896: bpf_trace_printk: Hello World 4533
如果您不记得跟踪管道的位置,可以使用命令 bpftool prog tracelog 获得相同的输出。
与第 2 章中的输出相比,这次每个事件都没有与之关联的命令或进程 ID;而是看到每行跟踪的开头都是 <idle>-0。在第 2 章中,每个系统调用事件都是因为用户空间中执行命令的进程调用了系统调用 API。该进程 ID 和命令是 eBPF 程序执行的上下文的一部分。但在这里的示例中,XDP 事件是由于网络数据包的到达而发生的。此时没有与该数据包关联的用户空间进程——当 eBPF 程序 hello 被触发时,系统除了在内存中接收该数据包外,还没有对其执行任何操作,也不知道该数据包是什么或要去哪里。
正如预期的那样,您可以看到跟踪输出的计数器值每次递增 1。在源代码中,counter 是一个全局变量。让我们看看如何在 eBPF 中使用映射实现这一点。
全局变量
正如您在前一章中所了解到的,eBPF 映射是一种可以从 eBPF 程序或用户空间访问的数据结构。由于同一映射可以由同一程序的不同运行多次访问,因此它可以用于在不同执行之间保存状态。多个程序也可以访问同一映射。由于这些特性,映射语义可以被用作全局变量。
note
在 2019 年增加对全局变量的支持之前,eBPF 程序员必须显式编写映射来执行相同的任务。
您之前看到 `bpftool 显示此示例程序使用了两个 ID 为 165 和 166 的映射。(如果您自己尝试,可能会看到不同的 ID,因为这些 ID 是在内核中创建映射时分配的)。让我们来探索一下这些映射包含的内容。
bpftool 工具可以显示加载到内核中的映射。为清晰起见,我将只展示与“Hello World”示例程序相关的条目 165 和 166:
$ bpftool map list
165: array name hello.bss   flags 0x400
    key 4B value 4B max_entries 1 memlock 4096B
    btf_id 254
166: array name hello.rodata flags 0x80
    key 4B value 15B max_entries 1 memlock 4096B
    btf_id 254 frozen
在从 C 程序编译的目标文件中,bss6 段通常保存全局变量,您可以使用 bpftool 检查其内容,如下所示:
$ bpftool map dump name hello.bss
[{
        "value": {
            ".bss": [{
                    "counter": 11127
                }
            ]
        }
    }
]
我也可以使用 bpftool map dump id 165 来检索相同的信息。如果我再次运行这些命令中的任何一个,我会看到计数器增加了,因为每当接收到网络数据包时,程序都会运行。
正如您将在第 5 章中了解到的,bpftool 只有在 BTF 信息可用时才能美化地打印出映射中的字段名称(在这里是变量名称 counter),并且只有在使用 -g 标志编译时才会包含这些信息。如果在编译步骤中省略了该标志,您会看到如下内容:
$ bpftool map dump name hello.bss
key: 00 00 00 00 value: 19 01 00 00
Found 1 element
没有 BTF 信息,bpftool 无法知道源代码中使用的变量名称。由于此映射中只有一项,您可以推断出十六进制值 19 01 00 00 必定是 counter 的当前值(十进制为 281,因为字节的顺序最低有效位)。
您在此看到 eBPF 程序使用映射语义来读写全局变量。在检查另一个映射时,如您所见,映射还用于保存静态数据。
另一个名为 hello.rodata 的映射暗示这可能是与我们的 hello 程序相关的只读数据。您可以转储此映射的内容,以查看它包含 eBPF 程序用于跟踪的字符串:
$ bpftool map dump name hello.rodata
[{
        "value": {
            ".rodata": [{
                "hello.____fmt": "Hello World %d"
                }
            ]
        }
    }
]
如果您没有使用 -g 标志编译目标文件,您将看到如下输出:
$ bpftool map dump id 166
key: 00 00 00 00    value: 48 65 6c 6c 6f 20 57 6f  72 6c 64 20 25 64 00
Found 1 element
此映射中有一个键值对,该值包含以 0 结尾的 12 个字节的数据。您可能不会惊讶于这些字节是字符串 "Hello World %d" 的 ASCII 表示。
现在我们已经完成了对这个程序及其映射的检查,是时候清理它了。我们首先将其与触发它的事件分离。
分离程序
您可以通过如下命令将程序从网络接口分离(detach):
$ bpftool net detach xdp dev eth0
如果该命令成功运行,则不会有输出,但您可以通过 bpftool net list 的输出中缺少 XDP 条目,来确认程序已不再附加:
$ bpftool net list
xdp:

tc:

flow_dissector:
然而,程序仍然加载在内核中:
$ bpftool prog show name hello
395: xdp name hello tag 9d0e949f89f1a82c gpl
    loaded_at 2022-12-19T18:20:32+0000 uid 0
    xlated 48B jited 108B memlock 4096B map_ids 4
卸载程序
目前,还没有 bpftool prog load 的反向命令(至少在撰写本文时没有),但您可以通过删除固定的伪文件来从内核中移除该程序:
$ rm /sys/fs/bpf/hello
$ bpftool prog show name hello
由于程序不再加载在内核中,因此此 bpftool 命令没有输出。
BPF 到 BPF 调用(BPF to BPF Calls)
在上一章中,您看到了尾调用的应用,并且我提到现在还可以从 eBPF 程序中调用函数。让我们来看一个简单的例子,与尾调用示例一样,将其附加到 sys_enter 跟踪点,但这次它将跟踪输出系统调用的操作码。您可以在 chapter3/hello-func.bpf.c 中找到代码。
出于演示目的,我编写了一个非常简单的函数,用于从跟踪点参数中提取系统调用操作码:
static __attribute((noinline)) int get_opcode(struct bpf_raw_tracepoint_args *ctx) {
    return ctx->args[1];
}
在可能的情况下,编译器可能会内联这个非常简单的函数,因为我只会从一个地方调用它。由于这会削弱这个示例的意义,我添加了 __attribute((noinline)) 来强制编译器不内联。在正常情况下,您可能应该省略这一点,并允许编译器根据需要进行优化。
调用该函数的 eBPF 函数如下所示:
SEC("raw_tp")
int hello(struct bpf_raw_tracepoint_args *ctx) {
    int opcode = get_opcode(ctx);
    bpf_printk("Syscall: %d", opcode);
    return 0;
}
将其编译为 eBPF 目标文件后,您可以使用 bpftool 将其加载到内核中并确认它已加载:
$ bpftool prog load hello-func.bpf.o /sys/fs/bpf/hello
$ bpftool prog list name hello
893: raw_tracepoint name hello tag 3d9eb0c23d4ab186 gpl
    loaded_at 2023-01-05T18:57:31+0000 uid 0
    xlated 80B  jited 208B   memlock 4096B   map_ids 204
    btf_id 302
这个练习的有趣部分是检查 eBPF 字节码以查看 get_opcode() 函数:
$ bpftool prog dump xlated name hello
int hello(struct bpf_raw_tracepoint_args * ctx):
; int opcode = get_opcode(ctx);  # 1
    0: (85) call pc+7#bpf_prog_cbacc90865b1b9a5_get_opcode
; bpf_printk("Syscall: %d", opcode);
    1: (18) r1 = map[id:193][0]+0
    3: (b7) r2 = 12
    4: (bf) r3 = r0
    5: (85) call bpf_trace_printk#-73584
; return 0;
    6: (b7) r0 = 0
    7: (95) exit
int get_opcode(struct bpf_raw_tracepoint_args * ctx):  # 2
; return ctx->args[1];
    8: (79) r0 = *(u64 *)(r1 +8)
; return ctx->args[1];
    9: (95) exit
- 在这里,您可以看到 eBPF 程序
hello()调用了get_opcode()。偏移量为0的 eBPF 指令是0x85,根据指令集文档,对应于“函数调用”。接下来,不会继续执行下一条指令(即偏移量为1的指令),而是会跳过七条指令(pc+7),这意味着将执行偏移量为8的指令。 - 这是
get_opcode()的字节码,正如您所希望的那样,第一条指令偏移量为8。
函数调用指令需要将当前状态放在 eBPF 虚拟机的栈上,以便在被调用函数退出时,可以在调用函数中继续执行。由于栈大小限制为 512 字节,因此 BPF 到 BPF 的调用不能嵌套得太深。
note
关于尾调用和 BPF 到 BPF 调用的更多细节,请参阅 Jakub Sitnicki 在 Cloudflare 博客上的一篇优秀文章:“Assembly within! BPF tail calls on x86 and ARM”。
总结
在本章中,您看到了如何将一些示例 C 源代码转换为 eBPF 字节码,然后编译为机器代码,以便在内核中执行。您还学习了如何使用 bpftool 检查加载到内核中的程序和映射,以及如何附加到 XDP 事件。
此外,您还看到了由不同事件触发的不同类型 eBPF 程序的示例。XDP 事件由网络接口上的数据包到达触发,而 kprobe 和 tracepoint 事件则是通过触发内核代码中的某些特定点来触发。在第 7 章中,我将讨论其他类型的 eBPF 程序。
您还学习了如何使用映射来实现 eBPF 程序的全局变量,并且看到了 BPF 到 BPF 的函数调用。
下一章将更深入地介绍当 bpftool 或其他用户空间代码加载程序并将其附加到事件时,在系统调用级别发生的事情。
练习
以下是一些可供尝试的内容,以便进一步探索 BPF 程序:
-
尝试使用如下所示的
ip link命令来附加和分离 XDP 程序:$ ip link set dev eth0 xdp obj hello.bpf.o sec xdp $ ip link set dev eth0 xdp off -
运行第 2 章中的任何 BCC 示例。当程序正在运行时,在第二个终端窗口使用
bpftool检查加载的程序。以下是我运行 hello-map.py 示例时看到的内容:$ bpftool prog show name hello 197: kprobe name hello tag ba73a317e9480a37 gpl loaded_at 2022-08-22T08:46:22+0000 uid 0 xlated 296B jited 328B memlock 4096B map_ids 65 btf_id 179 pids hello-map.py(2785)您还可以使用
bpftool prog dump命令查看这些程序的字节码和机器码。 -
在 chapter2 目录下运行 hello-tail.py,当它运行时,看看它加载的程序。当它正在运行时,查看它加载的程序。您将看到每个尾调用程序被单独列出,如下所示:
$ bpftool prog list
...
120: raw_tracepoint name hello tag b6bfd0e76e7f9aac gpl
    loaded_at 2023-01-05T14:35:32+0000 uid 0
    xlated 160B jited 272B memlock 4096B map_ids 29
    btf_id 124
    pids hello-tail.py(3590)
121: raw_tracepoint name ignore_opcode tag a04f5eef06a7f555 gpl
    loaded_at 2023-01-05T14:35:32+0000 uid 0
    xlated 16B jited 72B memlock 4096B
    btf_id 124
    pids hello-tail.py(3590)
122: raw_tracepoint name hello_exec tag 931f578bd09da154 gpl
    loaded_at 2023-01-05T14:35:32+0000 uid 0
    xlated 112B jited 168B memlock 4096B
    btf_id 124
    pids hello-tail.py(3590)
123: raw_tracepoint name hello_timer tag 6c3378ebb7d3a617 gpl
    loaded_at 2023-01-05T14:35:32+0000 uid 0
    xlated 336B jited 356B memlock 4096B
    btf_id 124
    pids hello-tail.py(3590)
您还可以使用
bpftool prog dump xlated来查看字节码指令,并将其与“BPF 到 BPF 调用”节中的内容进行比较。 -
请谨慎对待此问题,最好只是思考为什么会发生这种情况,而不是尝试实际操作! 如果您从 XDP 程序返回
0值,这对应于XDP_ABORTED,告诉内核中止对此数据包的任何进一步处理。考虑到在 C 中,0通常表示成功,这可能看起来有些违反直觉,但事实就是如此。因此,如果您尝试修改程序以返回0并将其附加到虚拟机的eth0接口,则所有网络数据包都会被丢弃。如果您使用 SSH 连接到该机器,这将是非常不幸的,您可能需要重启机器才能重新获得访问权限!您可以在容器中运行该程序,以便将 XDP 程序附加到仅影响该容器的虚拟以太网接口,而不是整个虚拟机。在 https://github.com/lizrice/lb-from-scratch 上有一个示例。
越来越多的 eBPF 程序也开始使用 Rust 编写,因为 Rust 编译器支持将 eBPF 字节码作为目标。
有一些指令的操作会受到指令中其他字段值的“修改”。例如,在内核 5.12 中引入了一组原子指令,这些指令包括在 imm 字段中指定操作类型的算术操作(ADD、AND、OR、XOR)。
-g 标志被用来生成 BTF 信息,这对于 CO-RE eBPF 程序是必需的,我将在第 5 章进行介绍。
通常情况下,eBPF 程序可以加载到内核中而不必固定到文件位置——但对于 bpftool 来说,这并非可选项,它必须将加载的程序固定。这个原因在“BPF 程序和映射引用”一节中有进一步的解释。
启用 JIT 编译需要在内核中启用CONFIG_BPF_JIT配置选项,并且在运行时可以通过net.core.bpf_jit_enable sysctl设置启用或禁用 JIT 编译。关于不同芯片架构上的 JIT 支持的更多信息,请参阅文档。
这里,bss 代表 “block started by symbol”。